文件预检
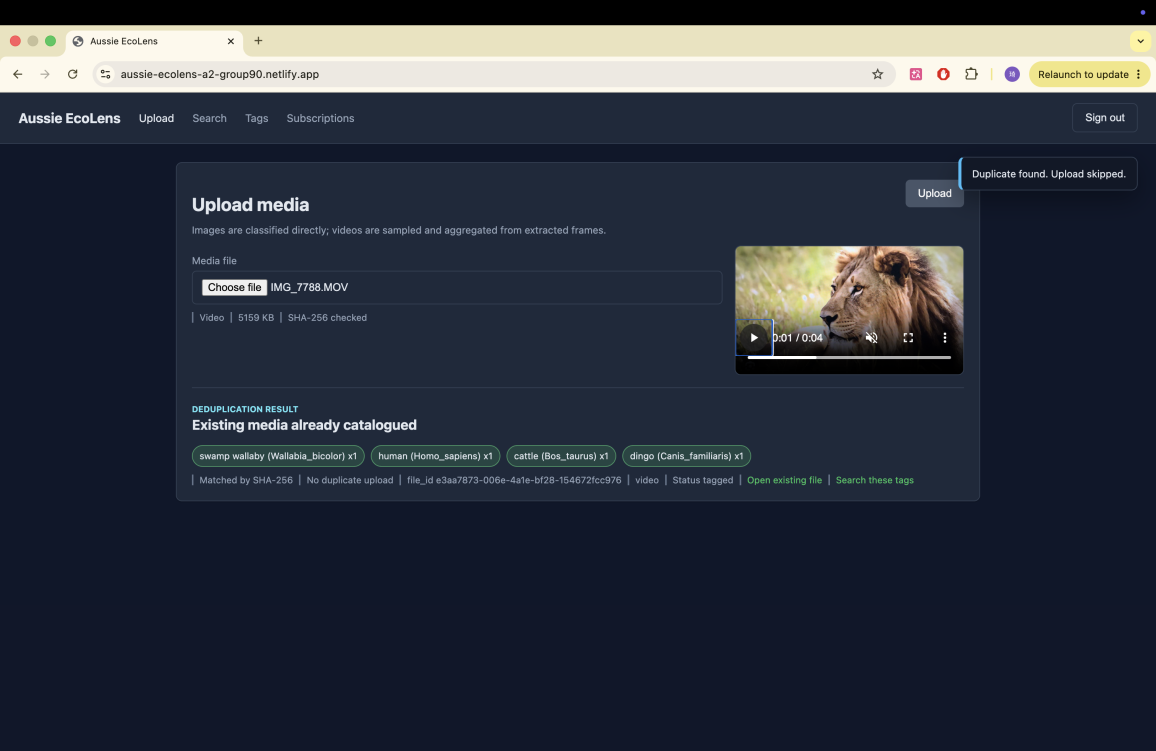
浏览器先计算 SHA-256。若文件已经存在,直接返回已有记录,不再重复上传和推理。
→AI PRODUCT PROJECT / 03
一张野生动物照片上传后,不该只是被存起来。系统还要判断它有没有重复、生成方便浏览的缩略图、从视频里抽出关键帧,再识别物种并把结果写回目录。我的工作,是把这些零散能力接成一条能持续运行的链路。
项目范围
我完成了 React 前端、Cognito 登录、文件去重、图片与视频处理、两阶段识别、DynamoDB 索引、查询与标签管理、物种订阅,以及 AWS 到 OCI 的审计链路。本页重点拆解媒体处理与 ML Pipeline。
我搭的链路
浏览器先计算 SHA-256。若文件已经存在,直接返回已有记录,不再重复上传和推理。
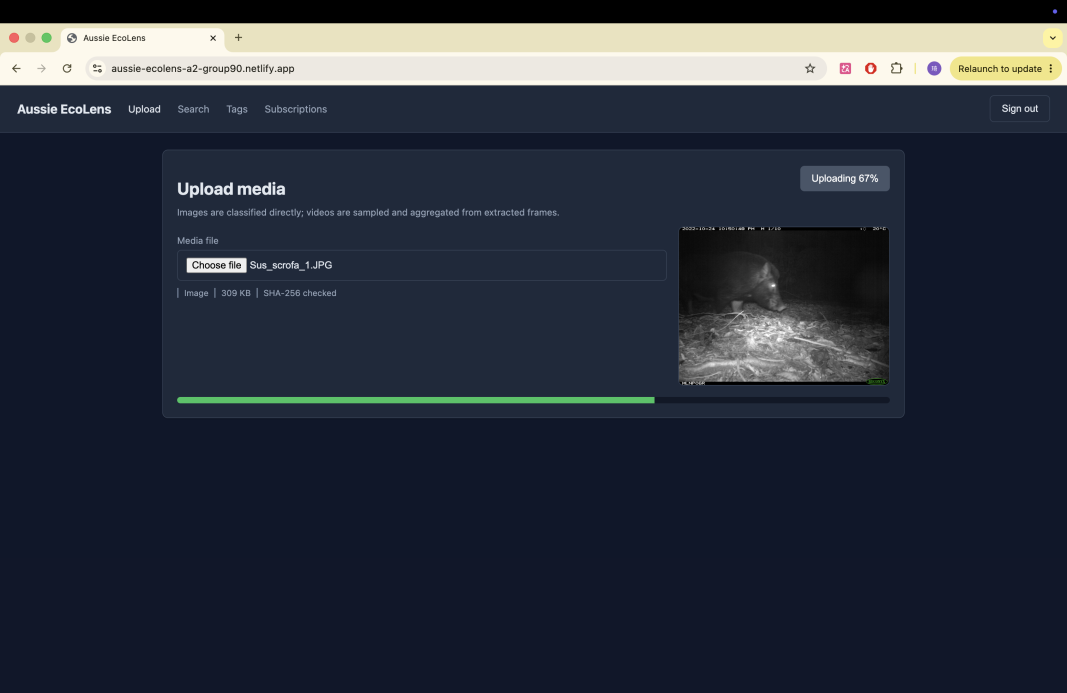
→图片保持比例生成压缩缩略图;视频按 1 fps 抽帧,避免把整段视频一次塞给模型。
→MegaDetector v5a 先找出画面里的动物,减少背景和无关区域对分类的干扰。
→SpeciesNet 再判断物种;阈值、冷启动和逐帧任务都被单独处理。
→把文件信息和标签写入 DynamoDB 的 Files / TagIndex,让后面的检索可以直接使用。
处理约束
| 环节 | 输入 | 关键判断 | 输出 / 证据 |
|---|---|---|---|
| 01文件预检 | SHA-256 文件摘要 | 命中已有文件时,停止重复上传与推理 | 已有文件与标签记录 |
| 02视频处理 | 视频文件 | 按 1 fps 拆成独立帧任务 | 抽帧任务 |
| 03目标检测 | 图片 / 视频帧 | 先由 MegaDetector v5a 定位动物区域 | 动物候选框 |
| 04物种分类 | 动物候选区域 | 再由 SpeciesNet 判断物种 | 物种标签 |
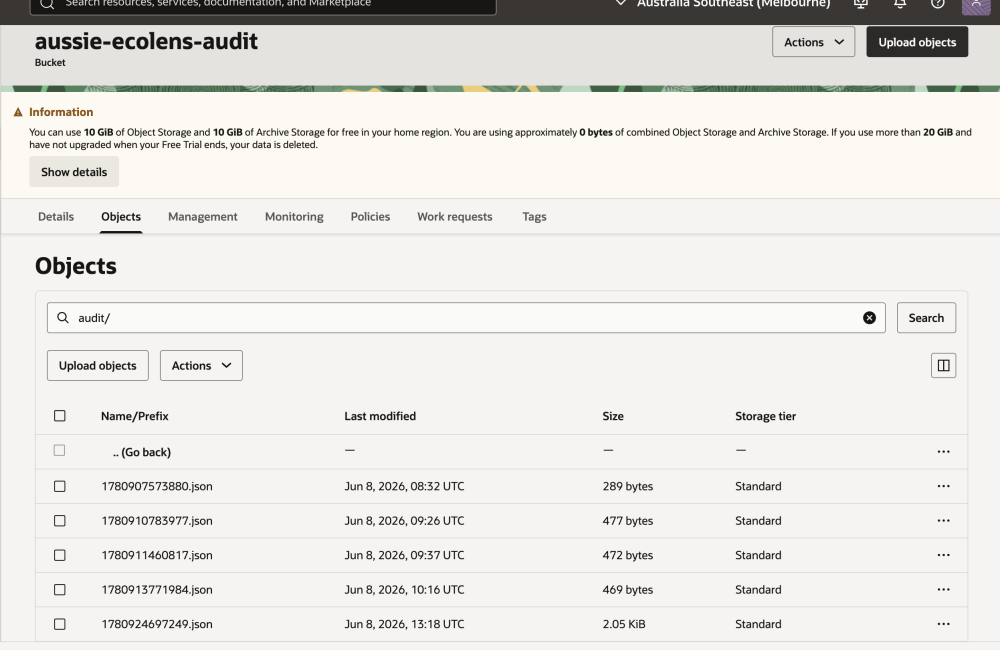
| 05跨云审计 | AWS 业务事件 | 将审计 JSON 写入 OCI Object Storage | 可追溯的跨云记录 |
产品判断
重复文件如果继续上传,会重复占用存储、推理时间和用户等待。把去重放在最前面,是最便宜也最确定的一次判断。
第一步回答“画面里有没有动物、在哪儿”,第二步再回答“它是什么”。链路更容易定位错误,也能分别调整阈值。
1 fps 是覆盖率与计算成本之间的取舍。每一帧独立分发,即使个别任务失败,也不必让整段视频重跑。
模型版本放在 DynamoDB 指针里。换模型时更新指针即可,不需要跟着改代码、重新部署整条链路。
运行证据
前两张图证明上传、去重和标签目录确实跑过;第三张图能看到 OCI Object Storage 中持续写入的审计 JSON。多云不是架构图上的两个框,而是 AWS 处理业务、OCI 留下跨云记录。
完整系统
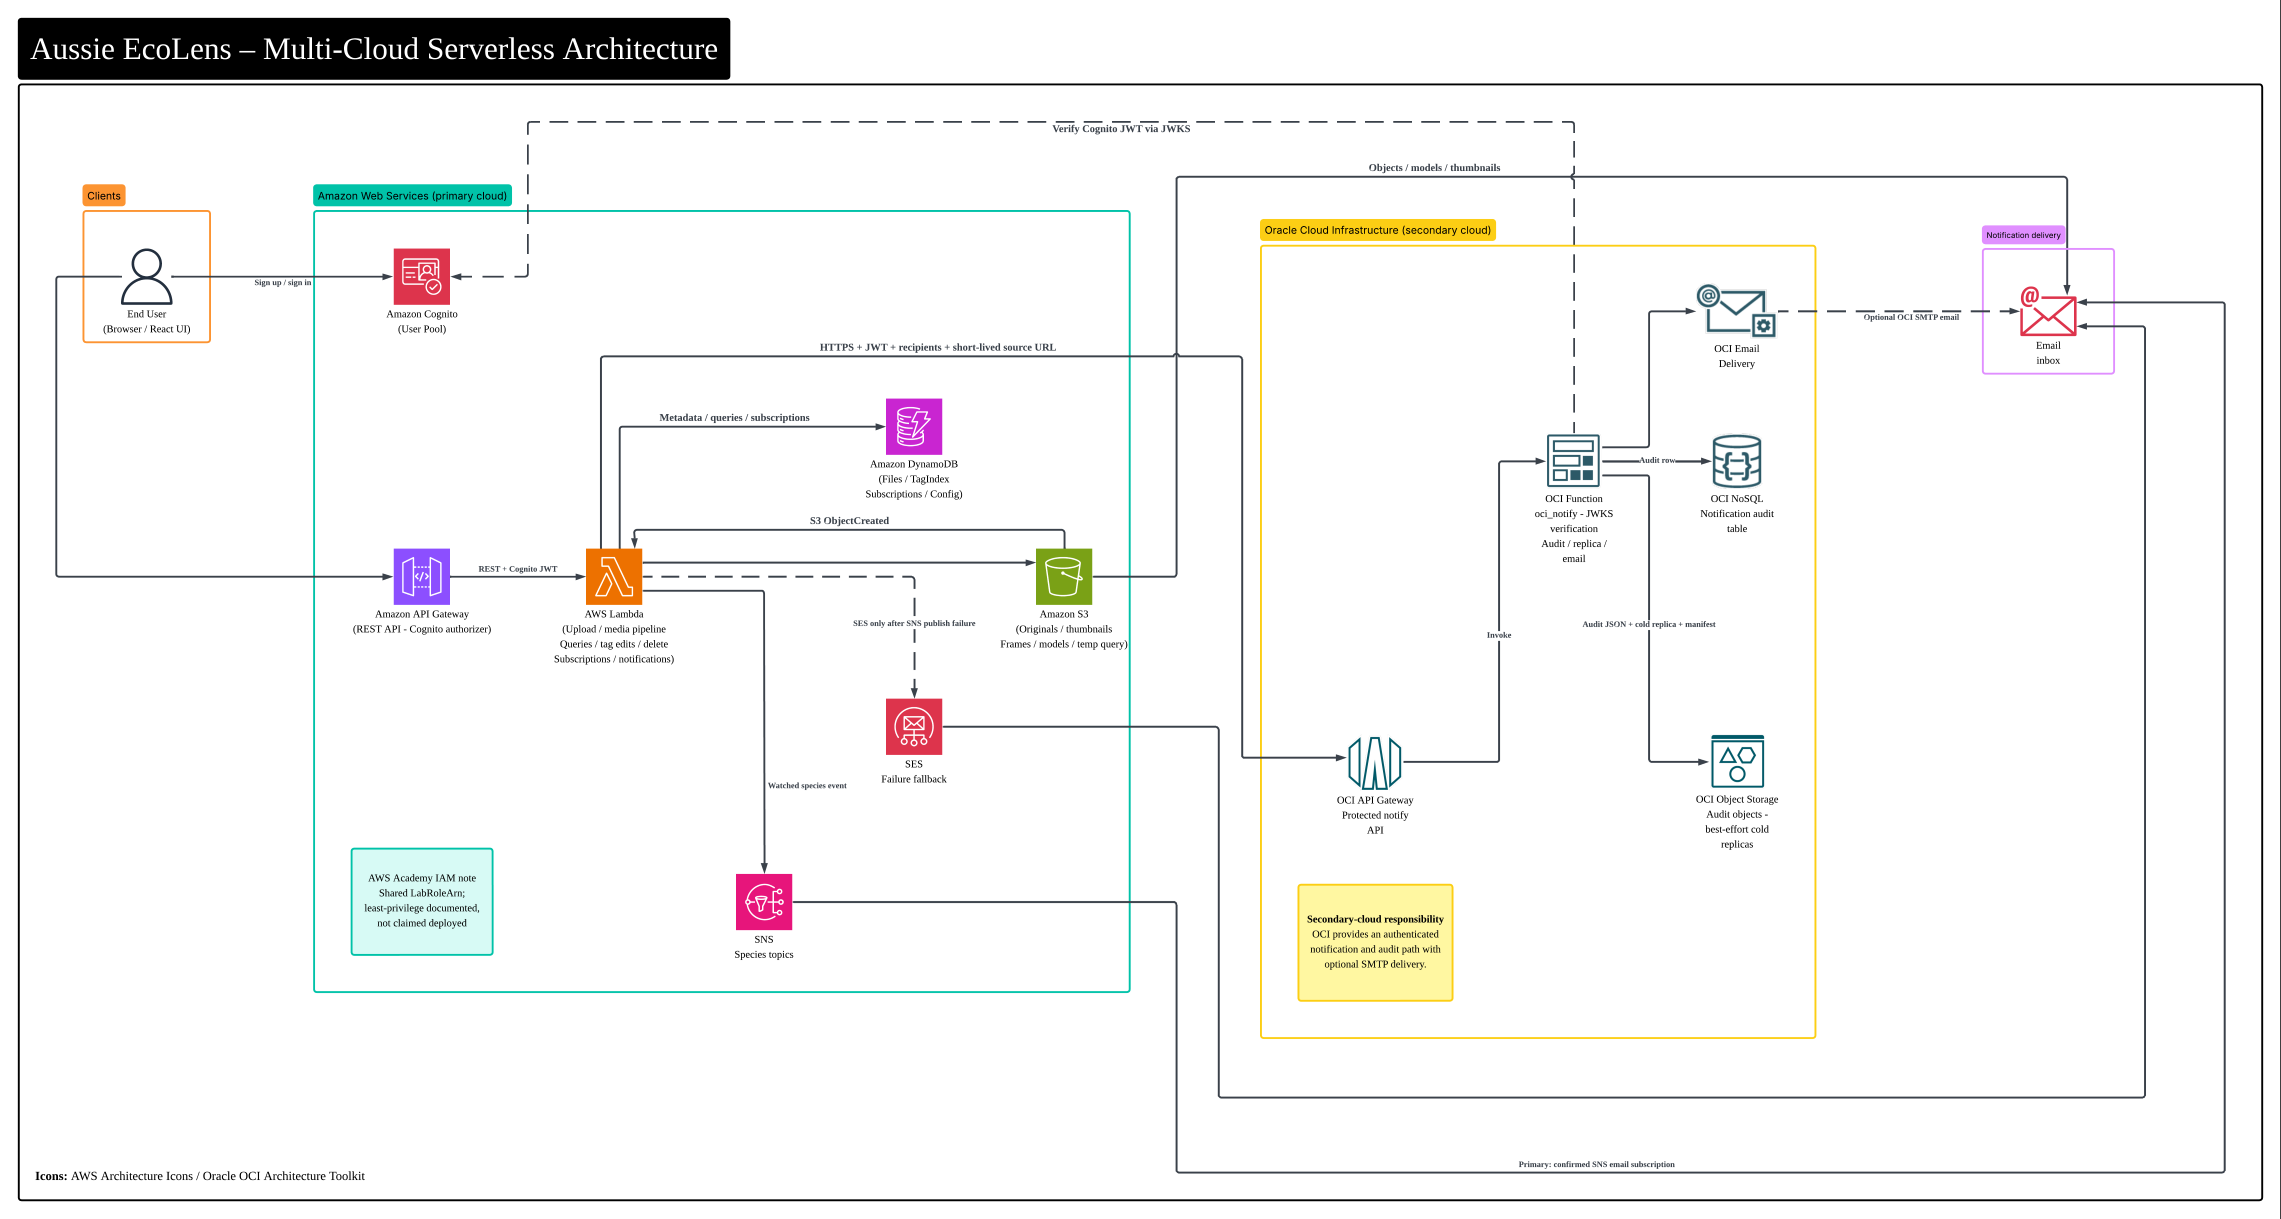
前端负责登录、上传、搜索和订阅;AWS 承接文件存储、媒体处理、模型推理和索引;OCI 留下跨云审计记录。用户从上传一张照片开始,最后能搜到识别结果,也能订阅关心的物种。
复盘
这次项目让我真正关心的,不只是模型能不能给出一个标签,而是重复文件要不要再跑、视频怎样拆才不会拖垮任务、失败能不能局部重试、模型升级会不会牵动整套系统。把这些选择想清楚,AI 才从一次推理变成一个可以继续使用的产品。